



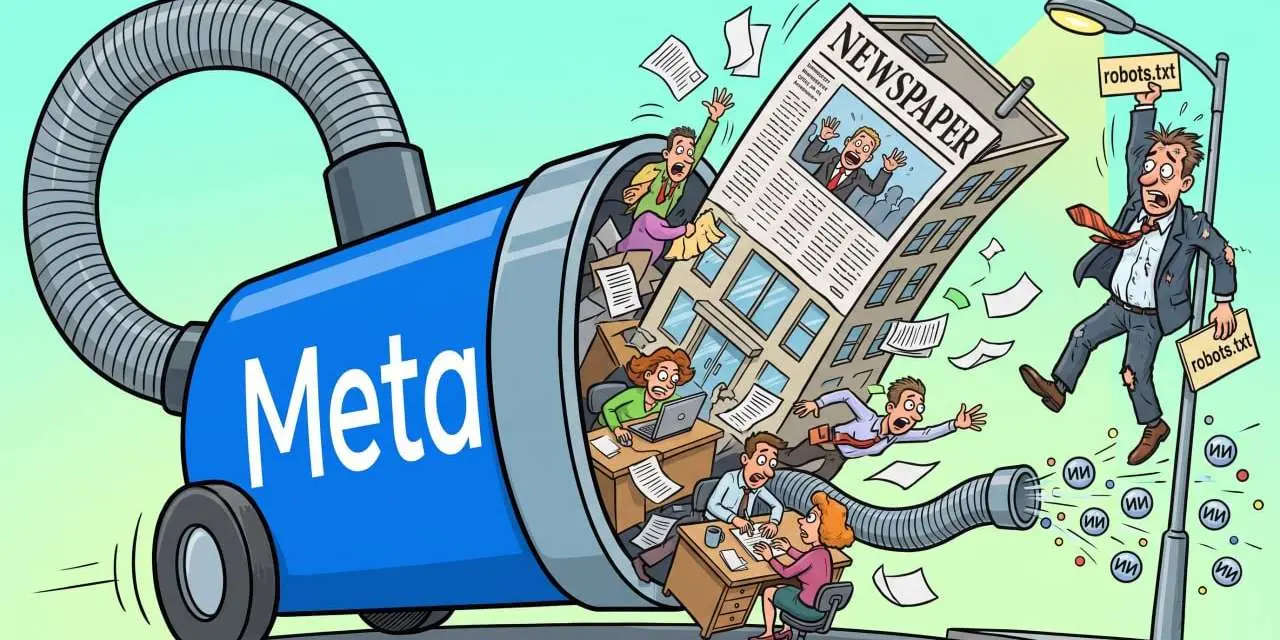
С 30 октября Meta получает право отправлять своих роботов на сайты, привязанные к бизнес-аккаунтам в Facebook, Instagram и WhatsApp, и обучать на их содержимом свой Искусственный интеллект. Отказаться от этого нельзя: условия сформулированы так, что продолжение работы с бизнес-инструментами Meta считается согласием. Об этом написала Nieman Lab (издание, которое изучает будущее журналистики), и юристы, опрошенные редакцией, уверены, что под формулировку подпадает почти каждое издание.
Новые коммерческие условия разрешают Meta запускать автоматические сборщики данных на сайтах, «связанных» с бизнес-аккаунтами компаний, которые ведут страницы в Facebook, каналы в Messenger, профили в Instagram или WhatsApp. Полученную информацию можно будет использовать для обучения продуктов Meta, а в определение «продуктов» входит «AI at Meta». Так компания называет все свое направление Искусственного интеллекта: исследования, модели Llama и Muse, а также ассистента Meta AI, встроенного в ее соцсети и мессенджеры. Кроме того, условия позволяют создавать «тестовые учетные данные» для доступа к доменам и страницам. Meta не уточнила, обойдет ли она с их помощью платный доступ к материалам, и как она будет определять, какой сайт «связан» с аккаунтом, тоже не сказано.
Позиция Meta проста: формулировки о сканировании раньше были разбросаны по нескольким документам, теперь их собрали в одном месте. На практике сканирование сайтов не изменится, и доступом по-прежнему можно управлять через файл robots.txt (текстовую «табличку» на сайте, в которой владелец сообщает алгоритмам, куда им можно заходить). Юристов это не убедило. Медиаюрист Мэтт Топик из Loevy & Loevy назвал положение «примечательным для того, чтобы прятать его в условиях использования» и посоветовал издателям исходить из того, что оно будет иметь силу. По его оценке, такой контент на рынке лицензирования стоил бы многих миллионов долларов.
Профессор права Корнелльского университета Джеймс Граммельманн считает, что для новостных сайтов это однозначное разрешение обучать ИИ на любых материалах, а Meta еще и сможет зарегистрироваться на ресурсе под видом пользователя, чтобы обойти необходимость регистрации. Специалист из Университета Висконсина Бенджамин Собел видит здесь «тайинг» (связывание), понятие из антимонопольного права: Meta ставит доступ к платформе в зависимость от согласия на сбор данных. Есть и тревога вокруг robots.txt. Эксперты допускают, что Meta будет утверждать: коммерческие условия важнее запрета в этом файле.
Неясной остается и юридическая сторона самого обучения. Вопрос о том, считается ли использование чужих материалов для тренировки моделей добросовестным (fair use), в США пока рассматривают суды. Эксперты считают, что суд может не признать такое положение исполнимым, но многие предполагают, что издателям лучше готовиться к худшему.
Сообщество при этом реагирует по-разному. Владелец небольшого сайта Steampunk Explorer Стивен Бил всерьез думает закрыть аккаунты до 30 октября, потому что «это просто злит». Редакция Nieman Lab сама отмечает, что имеет бизнес-аккаунт Meta. Рекомендация AI Weekly для издателей простая: получить от Meta письменное исключение до дедлайна либо вывести редакционный домен из бизнес-аккаунтов.
В тот же день Google рассказала о расширении платной пилотной программы для новостных редакций, в которой участвуют уже больше 400 изданий. Ее запустили в прошлом году вместе с The Washington Post и другими партнерами, и устроена она просто: Google платит за «доставку и использование расширенного контента», а на его основе делает новые функции Google News с Искусственным интеллектом, вроде подробных обзоров статей на страницах изданий и аудиобрифингов со ссылками на источники. Среди новых участников Axios, CNN, Financial Times и Forbes, а также региональные издания США. Выходит, что Google платит издателям за контент, а Meta назначает срок, после которого остается только согласиться с тем, что интеллектуальный продукт других она будет использовать бесплатно.


