



Беларусь не будет обучать свою большую языковую модель с нуля. Об этом на форуме «Искусственный интеллект в Беларуси» заявил министр связи и информатизации Кирилл Залесский. По его словам, создание такой модели с нуля обходится слишком дорого и занимает слишком много времени. Вместо этого страна берет открытые модели, достраивает вокруг них свои данные и правила и запускает все это на оборудовании внутри республики.
Звучит как отказ от амбиций, но, по сути, это выбор маршрута. Государственные заказчики получают рабочий инструмент за годы, а не за десятилетие, и чувствительные данные остаются на территории страны.
Работа идет в рамках госпрограммы «Цифровая Беларусь» на 2026–2030 годы. В ней есть подпрограммы «Экономика данных», «Цифровое государство» и «Цифровой суверенитет», а всего предусмотрено 21 мероприятие и около 1,08 млрд белорусских рублей. Национальный контур ИИ в публичных описаниях выглядит как инфраструктура, а не как один продукт: открытые большие языковые модели плюс так называемые контекстные слои. Контекстный слой — это данные, регламенты и ограничения доступа, которые накладываются на готовую модель, чтобы она отвечала по правилам конкретного ведомства, банка или предприятия.
Ключевая деталь касается места размещения. Оборудование ставят в Беларуси, и это делается ради данных, которые нельзя отправлять за рубеж. Речь идет о государственных информационных системах, банковской тайне и корпоративных массивах. Форум прошел в Национальной академии наук, в нем участвовали более 300 специалистов из пяти стран. Именно там контур представили как часть цифрового суверенитета, а не как отдельный чат-бот для граждан.
Почему не с нуля
Первая причина — в деньгах и времени, и министр назвал ее прямо. Вторая причина — в «железе». Обучение большой модели требует тысяч ускорителей, а в Беларуси нет рынка графических процессоров. Прямого канала поставок от Nvidia у Беларуси нет, экспортные ограничения США действуют с 2023 года, а оборудование приходит через третьи страны. Для масштаба: одна из характерных оценок для самого скромного обучающего стенда — двух карт H100 — начинается примерно с 50 тысяч долларов, и это только стоимость графических ускорителей, а не целой системы. По данным экспертов, самый мощный белорусский дата-центр потребляет 2,18 МВт, что для обучения передовой модели мало.
Третья причина — в данных. Большая модель нуждается в огромном корпусе текстов на нужном языке, и с белорусским здесь все не очень хорошо. Если не хватает даже такой информации, то с обучением универсальной LLM с нуля картина понятна.
Как это будет работать
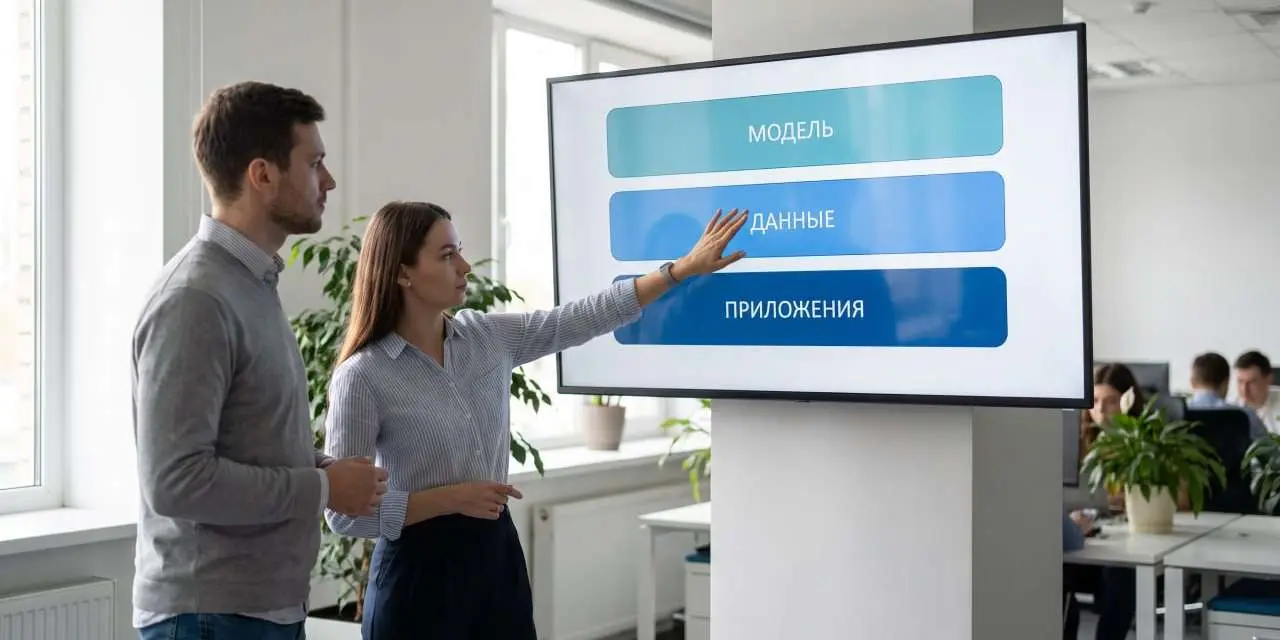
Логика строится на трех слоях. Нижний слой составляет открытая модель, которую государство берет как есть и размещает на своих серверах. Средний слой — это дообучение и контекст: терминология, нормативные акты, внутренние базы. Верхний слой образуют приложения для конкретных задач вроде работы с обращениями граждан, документами или городским транспортом. Подобные проекты в стране уже показывали, например нейросети для управления городским транспортом или то, что делает компания «Квантэк».
Правовая рамка складывается из того, что уже есть. Закон о защите персональных данных не требует обязательной локализации, но ограничивает трансграничную передачу. Одна из статей Банковского кодекса защищает банковскую тайну. Поэтому локальный контур для банков и госорганов выглядит естественно: проще разместить модель дома, чем доказывать законность отправки данных в чужое облако. Отдельный закон об ИИ пока готовят, а за основу берут модельный закон СНГ, принятый 18 апреля 2025 года. Сначала, по логике регуляторов, идут технические требования, потом отраслевые правила.
Какая модель станет базовой
Официального ответа нет. В источниках звучит только формула «открытые LLM плюс контекстные слои», без названия, разработчика, объема оборудования, бюджета контура и сроков запуска. Любой, кто называет конкретную модель, делает предположение. Мы тоже его сделаем.
Предположить можно по лицензиям. Для государственного проекта критично, чтобы лицензия разрешала коммерческое и внутреннее использование без согласований. Qwen3 и Mistral Small 3 выходят под Apache 2.0, DeepSeek R1 — под MIT, у Llama 3.3 своя лицензия сообщества с ограничениями, у моделей Nvidia Nemotron лицензия OpenMDW. Свежая Muse Spark Open от Meta идет по собственной лицензии с уведомительной оговоркой, которая касается крупных пользователей. Это означает, что юридически самыми чистыми выглядят Apache и MIT. Какие из них подойдут по качеству на русском и белорусском языках, покажут только тесты.
Наше предположение опирается только на эту логику. Первым кандидатом нам видится китайская Qwen3 от Alibaba: она выходит под Apache 2.0, а разработчики заявляют поддержку 119 языков и диалектов. Рядом с ней стоит DeepSeek с лицензией MIT. Третий вероятный вариант — российская GigaChat 3.5 от Сбера, ведь в сентябре компания открыла веса версии с режимом рассуждений под той же MIT, а сама модель изначально работает на русском языке.
Есть и политический фильтр. Партнерами по ИИ в официальных заявлениях называют Россию, Китай, Вьетнам и Индию, поэтому в списке реалистичных кандидатов китайские открытые модели присутствуют по понятной причине. Но это наша интерпретация, подтверждения в документах нет.
Как поступили другие
Белорусский выбор не уникален. Эмираты адаптировали модель Jais 3 на базе открытой K2 Horizon, а не растили с нуля. Швейцария выпустила Apertus 1.5 как продолжение собственной версии 1.0 с дообучением. Обе страны вкладывались в данные и языковую настройку, а не в повтор базового обучения. Минск, по сути, идет по тому же пути.
Остается практический вопрос, который легко проверить через год: появятся ли публичные тесты контура на белорусском языке и назовут ли в итоге модель-основу.


