



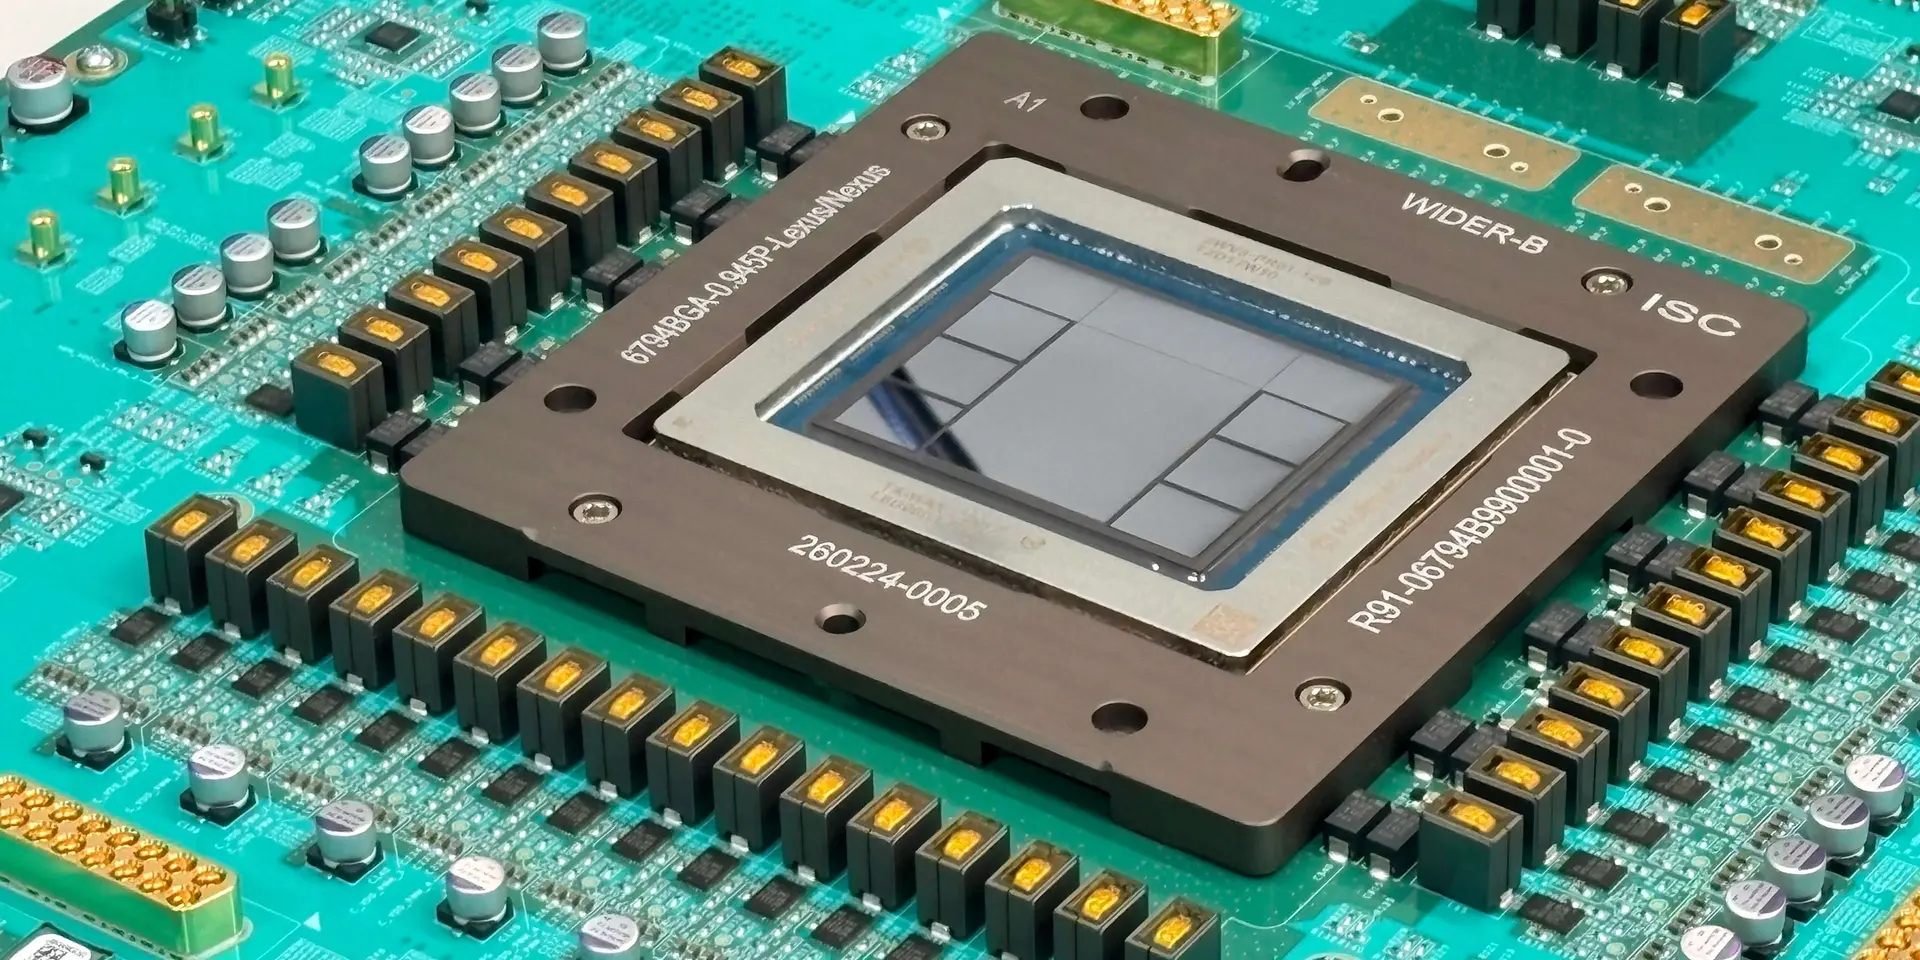
OpenAI сообщила, что ее модели переписали схемы блоков в собственном чипе Jalapeno и уменьшили площадь одного из них примерно на 13%, а другого на 10%. Для AMD такая же работа дала до 14% прироста по совокупности показателей (производительность, энергопотребление и размер кристалла, в отрасли их сводят в аббревиатуру PPA). На это ушло меньше пяти месяцев, тогда как подобный прогресс обычно занимает около года.
Jalapeno стал первым чипом OpenAI для инференса (запуска уже обученных моделей). Его разработали вместе с Broadcom и показали в июне. До передачи проекта на производство (этот этап называется тейп-аут) прошло девять месяцев при привычных полутора-двух годах. Инженерные образцы уже проверяют на рабочих нагрузках вроде GPT-5.3-Codex-Spark, а развертывание в дата-центрах назначено на конец 2026 года. По оценке Tom's Hardware, вычислительный чиплет (отдельный кристалл в составе сборки) занимает около 840 мм², почти предельный размер для современной литографии, и к нему подключается шесть модулей памяти HBM.
Выигрыш дали конкретные доработки. В вычислительном блоке warp engine модель оптимизировала сложение и умножение дробных чисел, функции преобразования и узел специальных операций, и площадь сократилась примерно на 13%. В матричном модуле (именно он выполняет основную часть работы нейросети) улучшились две детали. Сумматоры складывают числа. Схема скалярных произведений умножает пары величин и сразу суммирует итоги. Вычисления идут в низкой точности: у таких чисел мало знаков, поэтому они занимают немного места и экономят энергию. Результат — около 10% площади модуля. Еще один узел, умножитель, стал меньше примерно на 15%. Заодно он ускорился: результат теперь готов за один шаг внутренних часов чипа (такт), а раньше требовалось два. Меньший кристалл дешевле в производстве, а на высвободившемся месте помещается больше полезных блоков.
С AMD сотрудничество построено иначе. Модель переписала исходный код (RTL, описание аппаратной логики на языке SystemVerilog) для одного из главных блоков графического ускорителя AMD (чипа для дата-центров, на котором работают нейросети). Инженеры уже довели его вречную до хорошего состояния, а прибавка составила до 14% по совокупности показателей. Часть правок компания уже включила в версию, отправленную на производство, а остальное пока проверяет. Для следующего флагманского CPU (центрального процессора) AMD подтвердила однозначную прибавку по ключевым блокам. Проверять, что переписанная схема работает как прежняя, помогали инструменты Synopsys (американская фирма, на чьих разработках строят чипы). Вместе с ней OpenAI обучает модель GPT-Synopsys, которая должна пользоваться программами для автоматизации проектирования так, как і опытные инженеры.
Проверка шла и на двух открытых процессорах, PicoRV32 и Ibex. Оба построены на RISC-V (свободной архитектуре, которую вправе использовать любой желающий). Лучшей среди моделей оказалась GPT-6.2 Astra, обогнавшая GPT-6.1 Sol, GPT-6 Astra и GPT-5.6 Sol. У такой проверки есть слабое место, о котором пишут сами авторы. Когда нейросеть собирала процессорное ядро (главный вычислительный блок) с нуля по описанию, оценки получались высокими отчасти потому, что она могла пропустить часть функций оригинала, например счетчики производительности (встроенные датчики, которые измеряют скорость работы процессора).
Идея доверить ИИ проектирование чипов уже вызывала ожесточенные споры. В 2021 году Google опубликовала в Nature метод AlphaChip, который расставляет крупные блоки на кристалле, как мебель в тесной квартире, чтобы пути между ними вышли короче. Он учится на собственных пробах и ошибках (это называют обучением с подкреплением) и применялся в нескольких поколениях TPU (чипы Google для нейросетей). Эндрю Кахнг из Калифорнийского университета в Сан-Диего рецензировал эту статью, а потом решил проверить метод заново. Его команда сравнила AlphaChip с другими способами и в большинстве случаев преимущества не увидела: лучше оказались коммерческая программа Cadence и разработка Nvidia под названием AutoDMP. Google возразила, что в тех тестах пропустили предварительное обучение метода, без которого он работает хуже. Азалия Мирхосейни и Анна Голди, придумавшие AlphaChip, с августа 2022 года работают в Anthropic.
Эксперты отмечают, что тяжелое предобучение моделей, скорее всего, останется на оборудовании Nvidia, а собственные микросхемы возьмут на себя инференс. Глава Broadcom Хок Тан говорит о дата-центрах гигаваттного масштаба, которые начнут разворачиваться с 2026 года вместе с Microsoft и другими партнерами. Независимых замеров энергопотребления Jalapeno пока нет.


